
Pour les ingénieurs data
Un contrôle avant utilisation de chaque livraison chargée par votre pipeline.
Comparez chaque nouveau fichier ou table à la version approuvée. Obtenez un verdict et un code de sortie, et laissez votre pipeline décider de la suite. Aucun fichier de règles à écrire d'abord.
Cela vous parle ?
Le traitement est au vert. Les données, non.
Un fournisseur a renommé une colonne et le chargement a tout de même réussi.
Nos tests vérifient ce à quoi nous avons pensé. Le problème est toujours ailleurs.
Écrire et maintenir des contrôles pour chaque colonne de chaque flux est sans fin.
Ce que vous obtenez
Conçu pour les livraisons telles qu'elles arrivent vraiment.
Conditionnez le chargement aux données, pas au traitement
Une commande compare la nouvelle livraison à la version approuvée et renvoie un code que votre orchestrateur comprend. Ajoutez un fichier JUnit et les constats apparaissent dans la vue des tests de votre CI.
- Fonctionne sous Windows et Linux :
datainspec.exeest fourni avec l'installateur Windows, et le même moteur fonctionne sous Linux ou dans Docker - L'onglet Gate de l'application exporte la commande exacte pour votre traitement
# in your job, after the extract
datainspec scan \
  --baseline  orders_september.parquet \
  --candidate orders_october.parquet \
  --profile   orders.profile \
  --output    report.json \
--junit-xml report.xml| 0 | Clearnothing that needs attention |
|---|---|
| 1 | Warningfindings worth a look |
| 2 | Blockeda critical finding |
| 3 | Failedthe scan itself could not run |
Sachez exactement ce qui s'est dégradé
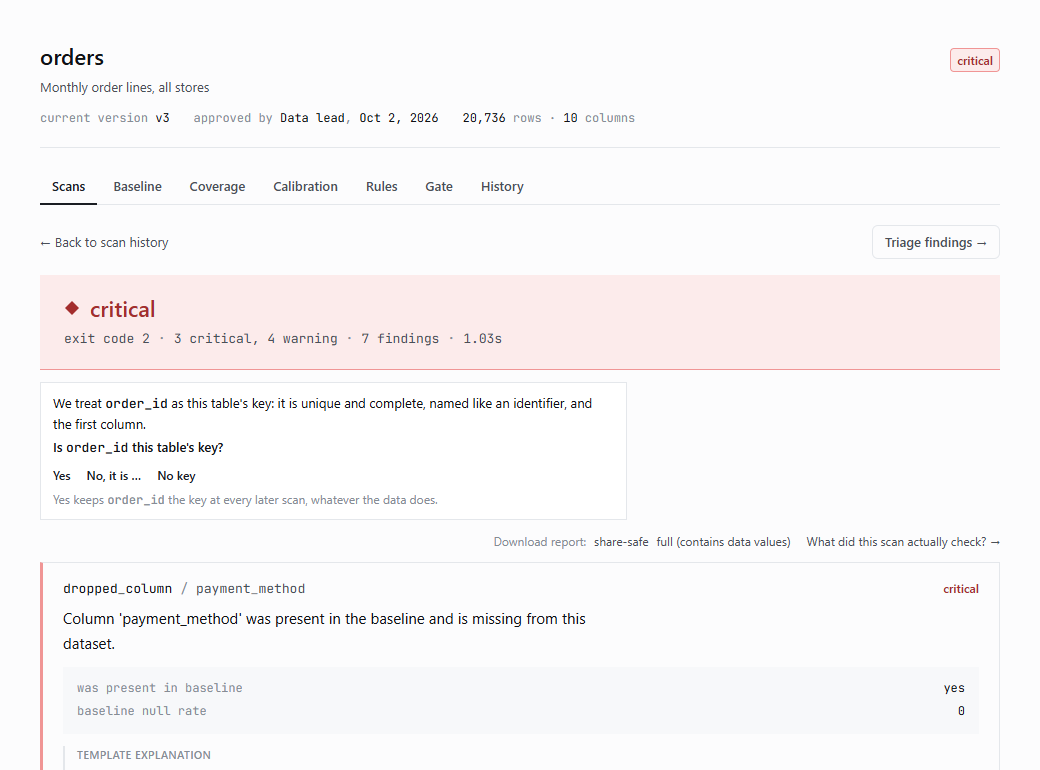
Le rapport JSON contient chaque constat en termes simples, avec ses éléments de preuve et les lignes concernées, pour partir de la cause au lieu de remonter les problèmes depuis un tableau de bord.
- Chaque constat nomme la colonne et ce qui a changé
- Des exemples de lignes, avec export complet possible
- Une version partageable sans données pour les tickets hors de l'équipe
Aucune règle au départ, la main quand vous le souhaitez
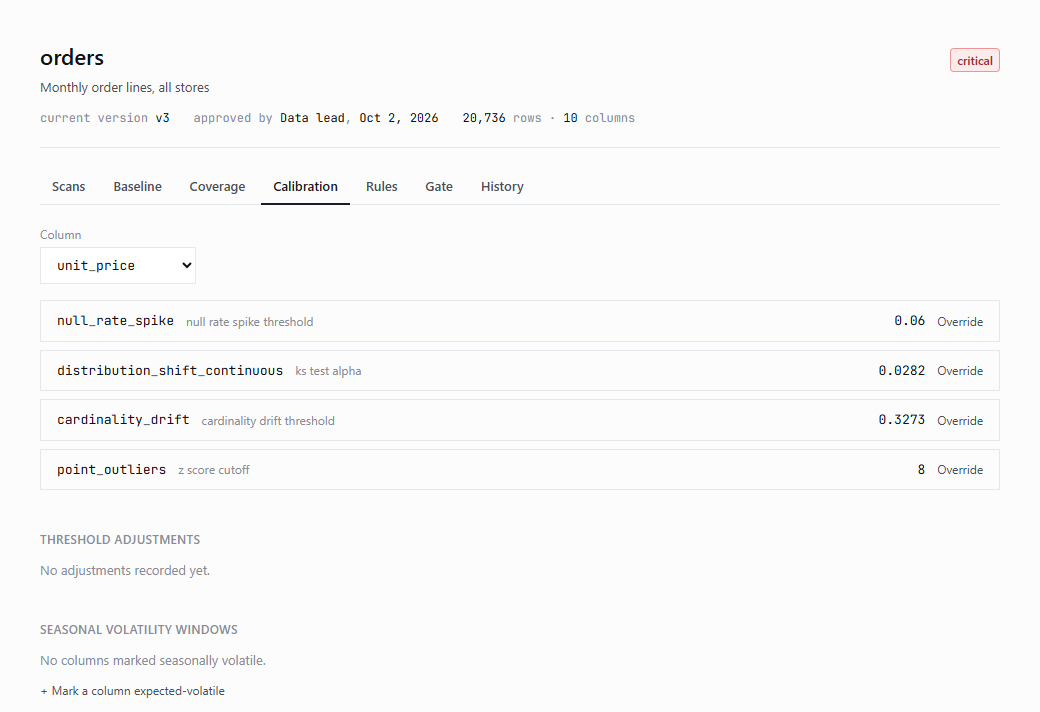
Il profile chaque colonne de la version que vous approuvez : son rôle, sa plage normale, les contrôles adaptés. Chaque seuil est visible et peut être modifié avec un motif.
- Mettez le profil en cache avec
--profile - Plages, valeurs autorisées et clé en YAML
- Importez ce que vous avez écrit pour dbt ou Great Expectations
Lit les fichiers réellement envoyés
Les fichiers et tables tels quels : un dossier de fragments CSV, Parquet, DuckDB, SQLite ou une base de données via son pilote avec la requête SELECT en lecture seule que vous fournissez. CSV issus d'Excel compris.
- 30 millions de lignes de chaque côté en environ 21 minutes sur un ordinateur portable
- Mémoire estimée avant une analyse volumineuse
- séparateur
- auto · virgule · point-virgule · barre verticale · tabulation
- encodage
- auto · utf-8 · Windows-1252 · ISO-8859-1/15
- décimales
- auto · point · virgule
- dates
- auto · jour-mois · mois-jour
- taille
- mémoire estimée avant l'analyse
Sa place dans votre pipeline
Une étape de plus, après l'extraction.
- 1La livraison arriveUn export fournisseur, un fichier partenaire, une table nocturne.
- 2Votre traitement lance l'analyseFace à la version approuvée, avec le profil en cache.
- 3Le code de sortie décide0 et 1 continuent ; 2 suspend l'étape suivante ; 3 indique que l'analyse elle-même a échoué.
- 4Une personne fait le triageDans l'application : problème réel, changement attendu ou bruit. La décision suit le constat jusqu'à l'analyse suivante.
La différence
Vos tests, plus une vérification de tout le reste.
Questions
Les questions des ingénieurs.
A-t-il besoin de son propre serveur ou de sa propre base de données ?
Non. Il fonctionne sur la machine où il est installé et lit vos fichiers et bases de données là où ils se trouvent. Ses propres enregistrements sont conservés dans un dossier de travail sur cette machine.
Combien de temps prend une analyse ?
Cela dépend du volume. Un million de lignes de chaque côté a pris environ 35 secondes sur un ordinateur portable ; le répertoire français des entreprises, avec 30 millions de lignes de chaque côté, a pris environ 21 minutes.
Que signifie le code de sortie 3 ?
L'analyse elle-même n'a pas pu s'exécuter, par exemple à cause d'un fichier manquant. Votre pipeline peut traiter ce cas différemment d'un blocage.
Modifie-t-il mes données ?
Non. Il lit uniquement : DuckDB et SQLite sont ouverts en lecture seule, les bases de données reçoivent une session en lecture seule, et chaque requête passe par une protection qui refuse les écritures et les instructions multiples.
Placez-le en amont d'un flux.
Choisissez la livraison qui pose le plus de problèmes. Nous l'installons sur vos machines et examinons ensemble ce qu'il a détecté.