
Para ingenieros de datos
Un control previo al uso para cada entrega que carga su pipeline.
Compare cada nuevo archivo o tabla con la versión que usted aprobó. Obtenga un veredicto y un código de salida, y deje que su pipeline decida qué ocurre después. Sin archivo de reglas que escribir antes.
¿Le resulta familiar?
La tarea terminó en verde. Los datos no.
Un proveedor cambió el nombre de una columna y la carga aun así terminó correctamente.
Nuestras pruebas comprueban lo que se nos ocurrió. El fallo siempre es otra cosa.
Escribir y mantener controles para cada columna de cada fuente de datos nunca termina.
Qué obtiene
Creado para las entregas tal como llegan en la práctica.
Condicione la carga a los datos, no a la tarea
Un comando compara la nueva entrega con la versión aprobada y devuelve un código que su orquestador entiende. Añada un archivo JUnit y los hallazgos aparecerán en la vista de pruebas de su CI.
- Se ejecuta en Windows y Linux:
datainspec.exese incluye con el instalador de Windows, y el mismo motor se ejecuta en Linux o en Docker - La pestaña Gate de la aplicación exporta el comando exacto para su tarea
# in your job, after the extract
datainspec scan \
  --baseline  orders_september.parquet \
  --candidate orders_october.parquet \
  --profile   orders.profile \
  --output    report.json \
--junit-xml report.xml| 0 | Clearnothing that needs attention |
|---|---|
| 1 | Warningfindings worth a look |
| 2 | Blockeda critical finding |
| 3 | Failedthe scan itself could not run |
Sepa exactamente qué falló
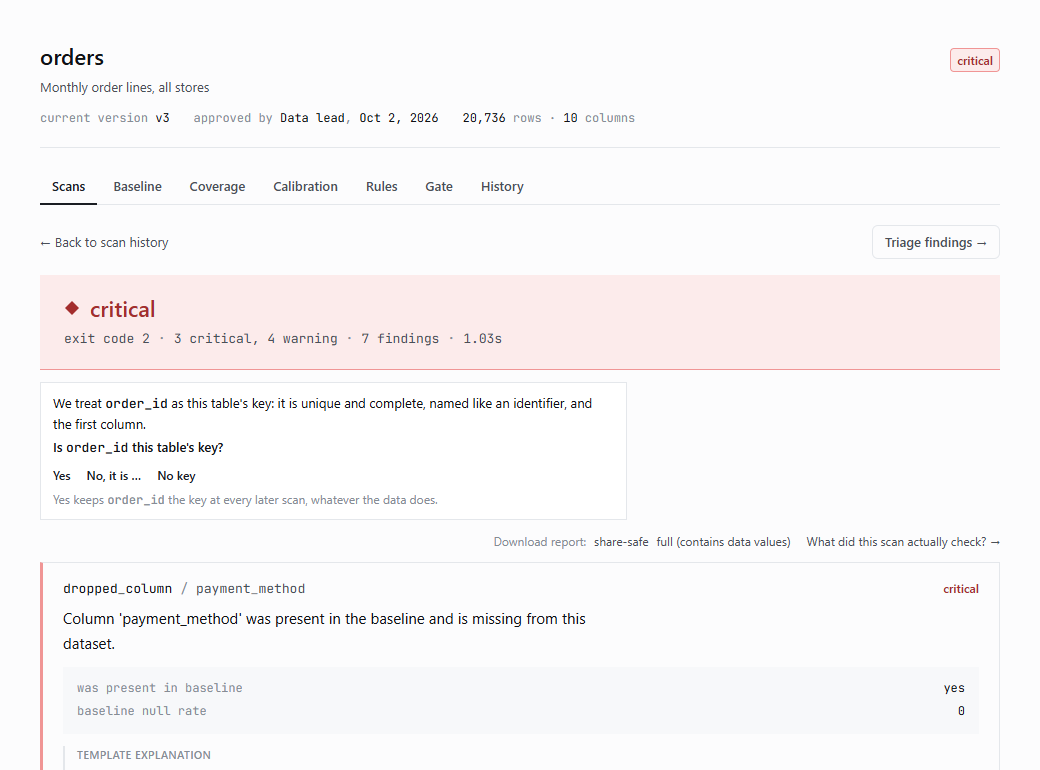
El informe JSON contiene cada hallazgo en palabras claras, con sus pruebas y las filas que lo explican, para que empiece por la causa en lugar de investigar hacia atrás desde un panel.
- Cada hallazgo indica la columna y qué cambió
- Filas de ejemplo, con exportación completa disponible
- Una versión compartible sin datos para incidencias fuera del equipo
Sin reglas para empezar, control total cuando lo quiera
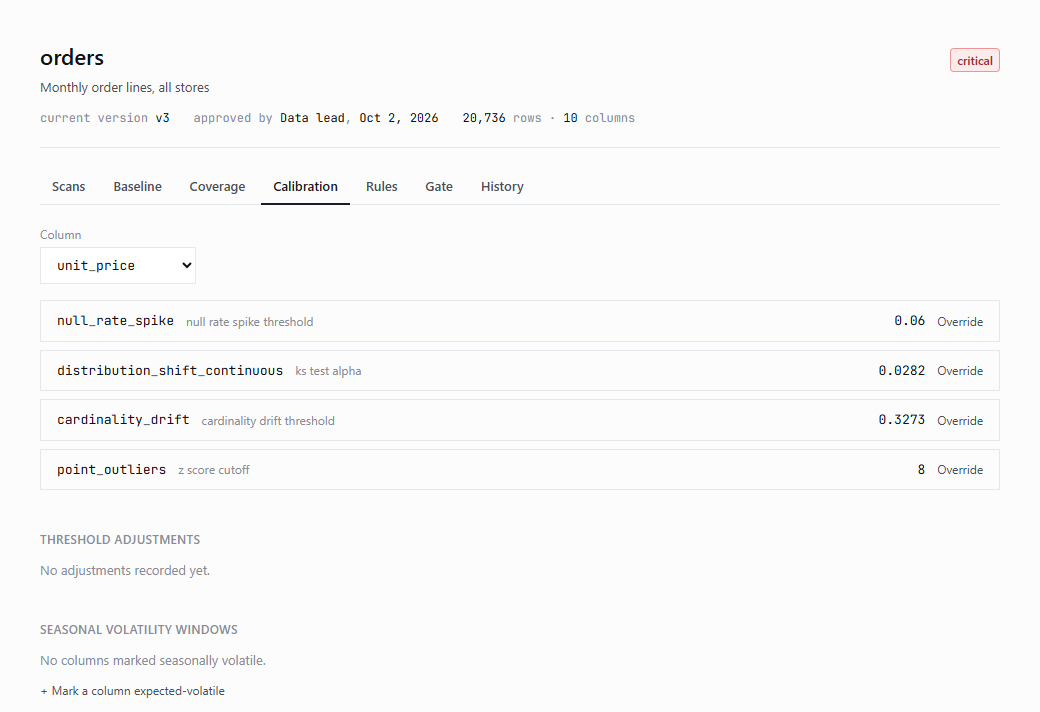
Perfila cada columna de la versión que usted aprueba: su rol, su rango normal y los controles adecuados. Todos los umbrales son visibles y pueden modificarse indicando el motivo.
- Guarde el perfil en caché con
--profile - Rangos, valores permitidos y clave en YAML
- Importe lo que escribió para dbt o Great Expectations
Lee los archivos que la gente envía realmente
Archivos y tablas tal como son: una carpeta con partes en CSV, Parquet, DuckDB, SQLite o una base de datos mediante su controlador, con la consulta SELECT de solo lectura que usted proporciona. Incluye los CSV de Excel.
- 30 millones de filas en cada versión en unos 21 minutos en un portátil
- Memoria estimada antes de un análisis grande
- separador
- automático · coma · punto y coma · barra vertical · tabulación
- codificación
- automática · utf-8 · Windows-1252 · ISO-8859-1/15
- decimal
- automático · punto · coma
- fechas
- automático · día-mes · mes-día
- tamaño
- memoria estimada antes del análisis
Cómo encaja en su pipeline
Un paso más, después de la extracción.
- 1Llega la entregaUna exportación de proveedor, un archivo de un socio, una tabla nocturna.
- 2Su tarea ejecuta el análisisFrente a la versión aprobada, con el perfil en caché.
- 3El código de salida decide0 y 1 permiten continuar; 2 detiene el siguiente paso; 3 indica que falló el propio análisis.
- 4Alguien clasifica los hallazgosEn la aplicación: problema real, cambio esperado o ruido. La decisión acompaña al hallazgo en el siguiente análisis.
La diferencia
Las pruebas que escribió, más un control de todo lo demás.
Preguntas
Lo que preguntan los ingenieros.
¿Necesita un servidor o una base de datos propios?
No. Se ejecuta en el equipo en el que está instalado y lee sus archivos y bases de datos donde están. Sus propios registros se guardan en una carpeta de trabajo de ese equipo.
¿Cuánto tarda un análisis?
Depende del tamaño. Un millón de filas en cada versión tardó unos 35 segundos en un portátil; el registro de empresas de Francia, con 30 millones de filas en cada versión, tardó unos 21 minutos.
¿Qué significa el código de salida 3?
El propio análisis no pudo ejecutarse, por ejemplo, por un archivo ausente. Su pipeline puede tratarlo de forma distinta a un bloqueo.
¿Modifica mis datos?
No. Solo lee: DuckDB y SQLite se abren en modo de solo lectura, las bases de datos utilizan una sesión de solo lectura y cada consulta pasa por un control que rechaza escrituras y sentencias múltiples.
Colóquelo antes de una fuente de datos.
Elija la entrega que más problemas le causa. Lo configuramos en sus equipos y revisamos juntos qué detectó.