
Für Data Engineers
Eine Freigabeprüfung für jede Lieferung Ihrer Pipeline.
Vergleichen Sie jede neue Datei oder Tabelle mit der Referenzversion. Sie erhalten ein Urteil und einen Exit-Code; Ihre Pipeline entscheidet, was als Nächstes geschieht. Keine vorab zu schreibende Regeldatei.
Kommt Ihnen das bekannt vor?
Der Job war grün. Die Daten nicht.
Ein Lieferant hat eine Spalte umbenannt, und der Ladevorgang war trotzdem erfolgreich.
Unsere Tests prüfen, woran wir gedacht haben. Der Fehler liegt immer woanders.
Prüfungen für jede Spalte jeder Datenlieferung zu schreiben und zu pflegen, hört nie auf.
Was Sie erhalten
Für Lieferungen, wie sie tatsächlich ankommen.
Die Daten entscheiden über das Laden
Ein Befehl vergleicht die neue Lieferung mit der Referenzversion und endet mit einem Code, den Ihr Orchestrator versteht. Ergänzen Sie eine JUnit-Datei, und die Befunde erscheinen in der Testansicht Ihrer CI.
- Läuft unter Windows und Linux:
datainspec.exewird mit dem Windows-Installer geliefert, dieselbe Engine läuft unter Linux oder in Docker - Die Registerkarte Gate der App exportiert den genauen Befehl für Ihren Job
# in your job, after the extract
datainspec scan \
  --baseline  orders_september.parquet \
  --candidate orders_october.parquet \
  --profile   orders.profile \
  --output    report.json \
--junit-xml report.xml| 0 | Clearnothing that needs attention |
|---|---|
| 1 | Warningfindings worth a look |
| 2 | Blockeda critical finding |
| 3 | Failedthe scan itself could not run |
Genau wissen, was schiefging
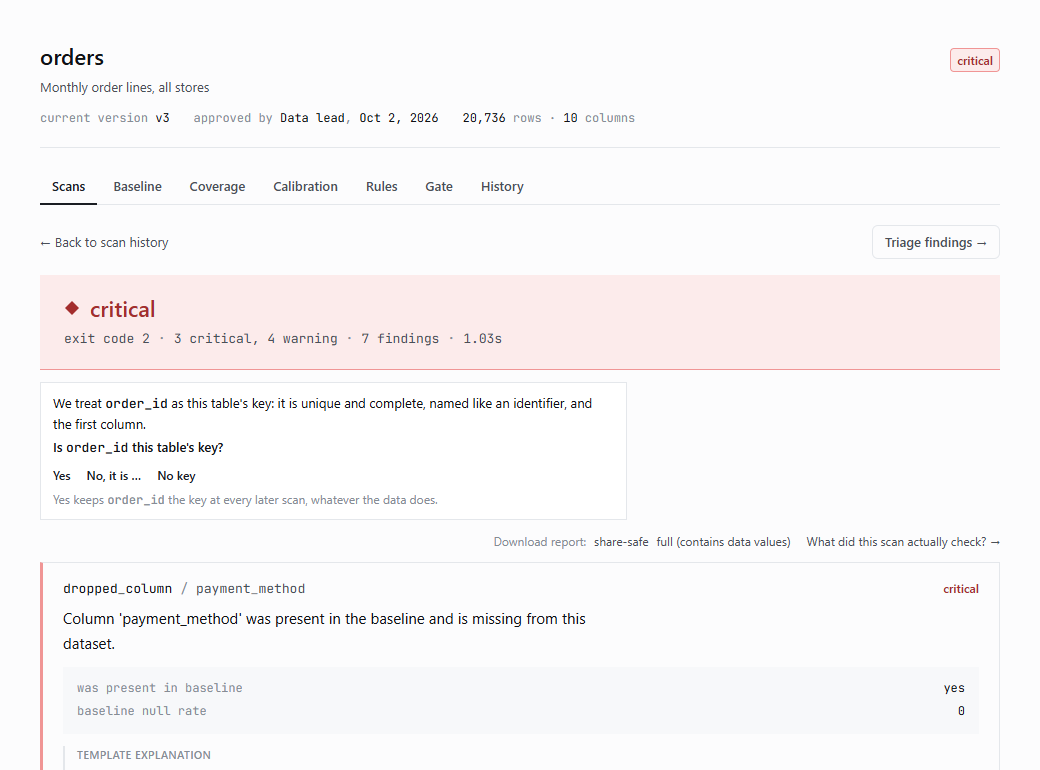
Der JSON-Bericht enthält jeden Befund in klaren Worten, mit Belegen und den zugehörigen Zeilen. So beginnen Sie bei der Ursache, statt vom Dashboard aus rückwärts nach Fehlern zu suchen.
- Jeder Befund nennt die Spalte und die Änderung
- Beispielzeilen, vollständig exportierbar
- Eine teilbare Fassung ohne Daten für Tickets außerhalb des Teams
Ohne Regeln starten, bei Bedarf volle Kontrolle
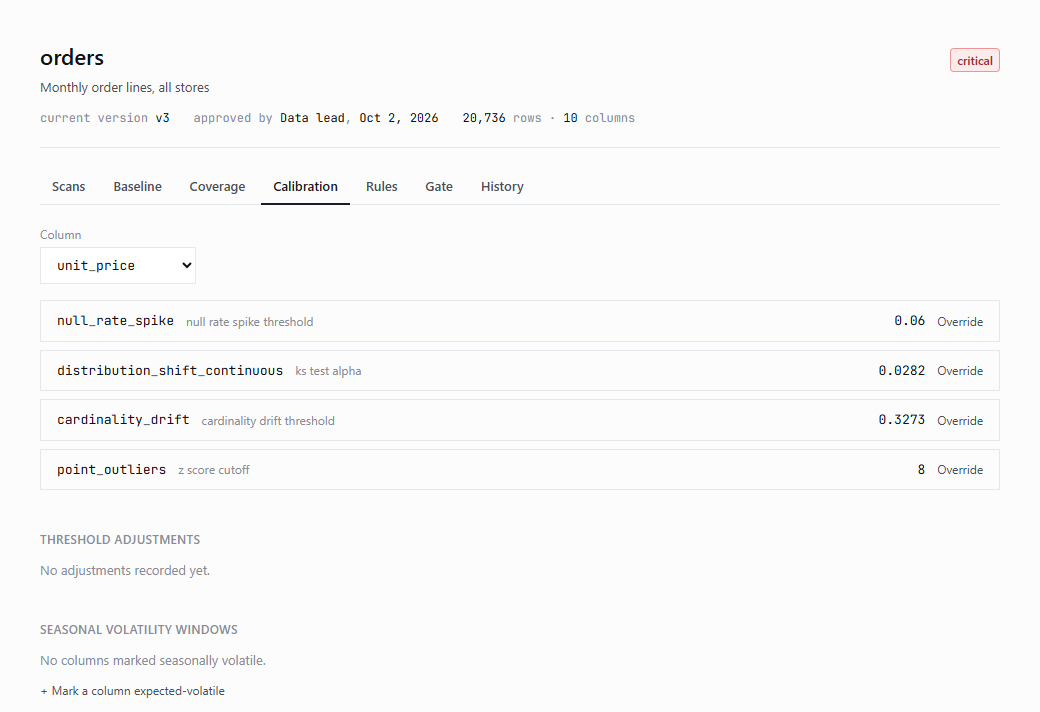
Jede Spalte der Referenzversion wird profiliert: Rolle, normaler Wertebereich und passende Prüfungen. Jeder Schwellenwert ist sichtbar und lässt sich mit Begründung anpassen.
- Das Profil mit
--profilezwischenspeichern - Wertebereiche, zulässige Werte und der Schlüssel in YAML
- Bestehende Regeln aus dbt oder Great Expectations importieren
Liest die Dateien, die tatsächlich geliefert werden
Dateien und Tabellen, wie sie sind: ein Ordner mit CSV-Teildateien, Parquet, DuckDB, SQLite oder eine Datenbank über ihren Treiber mit Ihrer nur lesenden SELECT-Abfrage. Auch CSV-Dateien im Excel-Stil.
- 30 Millionen Zeilen je Seite in etwa 21 Minuten auf einem Laptop
- Speicherbedarf vor einem großen Scan geschätzt
- Trennzeichen
- automatisch · Komma · Semikolon · senkrechter Strich · Tabulator
- Zeichencodierung
- automatisch · utf-8 · Windows-1252 · ISO-8859-1/15
- Dezimalzeichen
- automatisch · Punkt · Komma
- Datumswerte
- automatisch · Tag-Monat · Monat-Tag
- Größe
- Speicherbedarf vor dem Scan geschätzt
So passt es in Ihre Pipeline
Ein weiterer Schritt nach der Extraktion.
- 1Die Lieferung trifft einEin Lieferantenexport, eine Partnerdatei, eine nächtliche Tabelle.
- 2Ihr Job startet den ScanGegen die Referenzversion, mit dem zwischengespeicherten Profil.
- 3Der Exit-Code entscheidet0 und 1: weiter; 2: nächsten Schritt anhalten; 3: der Scan selbst ist fehlgeschlagen.
- 4Jemand ordnet die Befunde einIn der App: echtes Problem, erwartete Änderung oder Rauschen. Die Entscheidung bleibt dem Befund beim nächsten Scan zugeordnet.
Der Unterschied
Ihre Tests, ergänzt um eine Prüfung des Rests.
Fragen
Was Engineers fragen.
Braucht es einen eigenen Server oder eine Datenbank?
Nein. Es läuft auf dem Rechner, auf dem es installiert ist, und liest Ihre Dateien und Datenbanken dort, wo sie sind. Eigene Aufzeichnungen liegen in einem Arbeitsordner auf diesem Rechner.
Wie lange dauert ein Scan?
Das hängt von der Größe ab. Eine Million Zeilen je Seite dauerten auf einem Laptop etwa 35 Sekunden; das französische Unternehmensregister mit 30 Millionen Zeilen je Seite etwa 21 Minuten.
Was bedeutet Exit-Code 3?
Der Scan selbst konnte nicht ausgeführt werden, etwa wegen einer fehlenden Datei. Ihre Pipeline kann das anders behandeln als eine Sperre.
Verändert Datainspec meine Daten?
Nein. Es liest nur: DuckDB und SQLite werden nur lesend geöffnet, Datenbanken erhalten eine nur lesende Sitzung, und jede Abfrage durchläuft eine Schutzprüfung, die Schreibzugriffe und mehrere Anweisungen ablehnt.
Schalten Sie es vor eine Datenlieferung.
Wählen Sie die Lieferung, die am meisten Probleme macht. Wir richten es auf Ihren Rechnern ein und prüfen die erkannten Befunde gemeinsam.